Warum klingen so viele KI-Texte eigentlich gleich?
Hast Du solche Texte schon einmal auf Social Media gelesen?
„Es geht nicht darum, mehr zu verkaufen – sondern darum, die richtigen Kunden zu erreichen.“
„Das Problem ist nicht der sinkende Umsatz. Es ist der Moment, in dem die meisten Händler merken, dass ihre alten Strukturen kippen.“
„Das eigentliche Problem ist nicht, dass die alten Strukturen irgendwann kippen. Es ist der Moment, in dem viele erkennen, dass die meisten längst still geworden sind.“
„Erfolg ist längst kein Selbstzweck mehr.
Für viele braucht es:
Mut.
Haltung.
Klarheit.
Wer das verstanden hat, sucht keine Anerkennung mehr – und wird damit für viele zur Inspiration.“
Solche Formulierungen begegnen mir regelmäßig, beispielsweise auf LinkedIn. In Beiträgen, Kommentaren und fachlichen Diskussionen.
Und ich kenne sie aus meinen eigenen KI-generierten Textvorschlägen.
Die Beispiele sind bewusst überzeichnet. Trotzdem dürften sie vielen bekannt vorkommen: Künstliche Gegensätze, unbestimmte Verallgemeinerungen, bedeutungsschwere Aussagen und eine Dramaturgie, die aus einem einfachen Gedanken eine große Erkenntnis machen soll.
Ich nutze selbst ChatGPT für Entwürfe, Recherchen und die Prüfung meiner Texte. Dabei entdecke ich regelmäßig Formulierungen, die ich anschließend streiche oder umschreibe. Immer wieder fallen sie mir erst beim letzten Durchlesen auf.
Mich interessiert deshalb, warum Sprachmodelle so häufig auf diese Muster zurückgreifen, wie viel sich aus dem Schreibstil tatsächlich über die Herkunft eines Textes ableiten lässt und welche Möglichkeiten die technische KI-Erkennung bietet.
Vier sprachliche Muster, die mir immer wieder begegnen
Künstliche Gegensätze
„Es geht nicht um X, sondern um Y.“
Das klingt nach einer wichtigen Erkenntnis. Dabei wurde X häufig überhaupt nicht infrage gestellt. Der Gegensatz entsteht erst durch die Formulierung.
Ein solcher Kontrast kann rhetorisch sinnvoll sein. Wenn er in jedem zweiten Absatz auftaucht, verliert er seine Wirkung.
Unbestimmte Verallgemeinerungen und Weichmacher
„Viele Unternehmen erkennen möglicherweise erst zu spät …“
Wer sind „viele“? Was erkennen sie zu spät? Und warum nur möglicherweise?
Wörter wie „kann“, „vielleicht“ und „möglicherweise“ haben selbstverständlich ihre Berechtigung. Gerade bei unsicheren oder wissenschaftlichen Aussagen sind Einschränkungen wichtig.
Auffällig wird es, wenn mehrere davon ohne erkennbaren Grund in einem Satz stehen oder eine Behauptung so unbestimmt bleibt, dass sie kaum noch etwas aussagt.
Bedeutungsschwere Formulierungen
„Genau hier liegt der entscheidende Punkt.“
„An dieser Stelle beginnt die eigentliche Transformation.“
„Genau hier wurden sie still.“
Große Worte, wenig konkrete Information. Oft könnte man den Satz vollständig streichen, ohne dass dem Text etwas fehlen würde.
Künstliche Dramaturgie
Ein Gedanke, zehn Absätze. Jeder Satz eine eigene Zeile. Am Ende eine vermeintlich tiefgründige Erkenntnis, die in zwei Sätze gepasst hätte.
Kurze Absätze können Texte lesbarer machen. Wenn aber jeder Satz einen eigenen Auftritt bekommt, wirkt selbst eine alltägliche Beobachtung wie die Ankündigung einer historischen Entscheidung.
Warum KI-Texte so ähnlich klingen
Sprachmodelle erzeugen Text, indem sie auf Grundlage des bisherigen Kontexts wahrscheinliche Fortsetzungen berechnen. Sie haben dabei gelernt, welche Wörter, Satzstrukturen und Formulierungen in welchen Zusammenhängen häufig vorkommen.
Wenn ich ein Sprachmodell bitte, einen professionellen LinkedIn-Beitrag über Kommunikation zu verfassen, bekommt es zunächst eine ziemlich allgemeine Aufgabe.
Das Modell muss unter anderem entscheiden, wie es den Beitrag eröffnet, welche Argumente folgen und wie der Text endet. Ohne weitere Vorgaben greift es dabei gerne auf vertraute sprachliche Muster zurück.
Dann liest sich ein Beitrag über Führung plötzlich genauso wie einer über E-Commerce, Fitness, die Zukunft der Arbeit oder Blumentöpfe.
Lediglich die Fachbegriffe wurden ausgetauscht.
Das Problem beginnt schon beim Prompt
Nehmen wir an, ich möchte einen Beitrag über Produktpräsentationen im E-Commerce schreiben.
Ich könnte eine KI bitten:
„Schreibe einen professionellen und überzeugenden LinkedIn-Beitrag darüber, warum gute Produktpräsentationen wichtig sind.“
Das Ergebnis wird vermutlich brauchbar sein. Es könnte aber ebenso gut von jedem anderen E-Commerce-Experten stammen.
Die KI weiß schließlich noch gar nicht, was ich zu diesem Thema denke.
Wenn ich beispielsweise festgestellt habe, dass Produktbeschreibungen zwar technische Daten auflisten, aber wichtige Kundenfragen unbeantwortet lassen, gehört diese Beobachtung in den Prompt.
Dazu kann ich erklären, wie ich das Problem lösen würde und welche Erfahrungen ich damit gemacht habe.
Das gibt dem Text eine konkrete Richtung. Trotzdem kann ChatGPT anschließend Formulierungen einbauen, die ich selbst niemals verwenden würde.
Deshalb prüfe und redigiere ich jeden Entwurf, bevor ich ihn veröffentliche.
Wer tiefer einsteigen möchte: Im 121WATT-Podcast, Folge #157 spricht Sarah-Yasmin Hennessen mit Gidon Wagner darüber, wie sich mit KI Texte erstellen lassen, die über austauschbare Standardformulierungen hinausgehen.
Besonders interessant finde ich den Ansatz, Zielgruppe, Kernbotschaft und Struktur bereits vor dem Schreiben festzulegen und die eigene Expertise in den Prozess einzubringen.
Kann man KI-Texte an ihrem Stil erkennen?
Stell dir vor, du liest einen Beitrag und entdeckst darin gleich mehrere typische Formulierungen.
Du bist dir ziemlich sicher: Das hat ChatGPT geschrieben.
Vielleicht stimmt das sogar.
Vielleicht hat aber auch ein Mensch den Text verfasst, der regelmäßig solche Beiträge liest und deren Schreibstil übernommen hat.
Oder jemand hat einen KI-Entwurf vollständig überarbeitet und nur zwei der ursprünglichen Formulierungen stehen lassen.
Aus dem Stil allein lässt sich die Herkunft eines Textes deshalb nicht zuverlässig ableiten.
Wir können erkennen, dass ein Text austauschbar klingt. Ob und wie viel KI bei seiner Entstehung beteiligt war, wissen wir dadurch noch nicht.
Können spezielle Programme das besser?
KI-Detektoren: Wie soll das funktionieren?
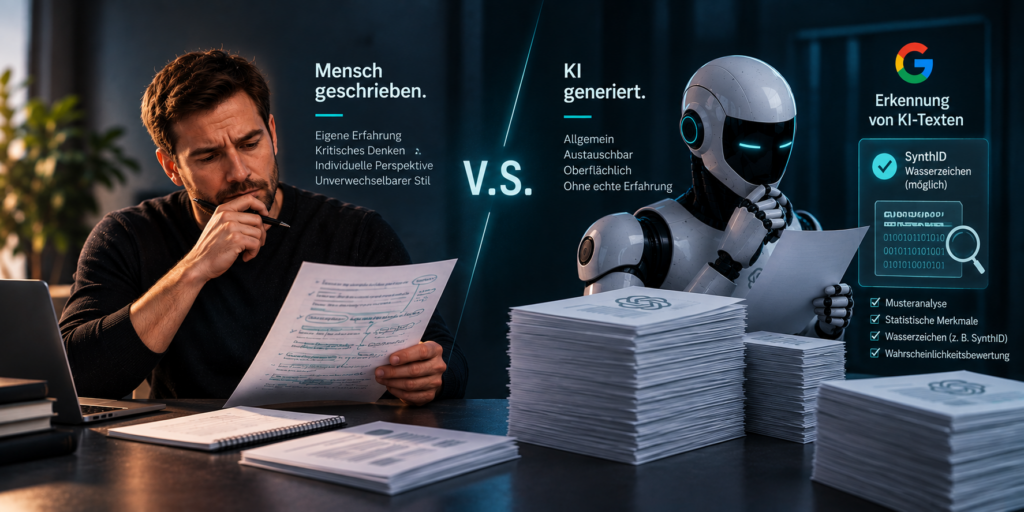
KI-Detektoren versuchen, anhand statistischer Merkmale einzuschätzen, ob ein Text wahrscheinlich von einem Sprachmodell erzeugt wurde.
Je nach Verfahren untersuchen sie beispielsweise Wortfolgen, sprachliche Vorhersagbarkeit oder andere Muster, die sich zwischen menschlichen und maschinell erzeugten Texten unterscheiden können.
Auch nachträgliche Bearbeitungen können die Einschätzung eines Detektors verändern.
Ein Mensch kann einen KI-Entwurf umschreiben, Absätze ergänzen oder Formulierungen austauschen. Umgekehrt kann ein selbst geschriebener Text sehr regelmäßig und vorhersehbar aufgebaut sein.
Hinzu kommen Unterschiede zwischen Sprachen, Textsorten und den verwendeten Sprachmodellen.
Ein Detektor, der bei einer bestimmten Art englischer KI-Texte gute Ergebnisse erzielt, muss bei einem kurzen deutschen LinkedIn-Beitrag nicht zwangsläufig dieselbe Leistung erreichen.
Besonders problematisch wird es, wenn aus einer statistischen Einschätzung eine persönliche Anschuldigung wird.
Ein angezeigter Wert von beispielsweise „90 % KI“ bedeutet nicht automatisch, dass mit 90-prozentiger Sicherheit nachgewiesen wurde, wer den Text geschrieben hat. Dafür müsste unter anderem klar sein, wie der jeweilige Detektor seinen Wert berechnet und wie zuverlässig er für genau diese Art von Text geprüft wurde.
Wer die Herkunft eines Textes beurteilen möchte, braucht definitiv mehr als eine einzelne Prozentanzeige.
Und was ist mit Wasserzeichen für KI-Texte?
Bei Bildern können sichtbare Wasserzeichen oder Metadaten Hinweise auf ihre Herkunft geben. Bei Texten ist das nicht so einfach.
Ein technisches Wasserzeichen für KI-generierte Texte kann beispielsweise dadurch entstehen, dass ein Sprachmodell bei der Wortauswahl gezielt ein bestimmtes statistisches Muster einbaut.
Für Leser bleibt dieses Muster normalerweise unsichtbar. Ein dafür entwickeltes Prüfverfahren kann es unter geeigneten Bedingungen erkennen.
Solche Verfahren sind aktuell Gegenstand wissenschaftlicher Forschung und praktischer Entwicklung.
Google hat beispielsweise mit SynthID Text ein Verfahren vorgestellt, das ein Wasserzeichen während der Textgenerierung einbettet.
Das bedeutet jedoch nicht, dass sich damit jeder beliebige KI-Text erkennen lässt.
Wie gut sich das Wasserzeichen erkennen lässt, hängt unter anderem von der Textlänge und dem jeweiligen Verfahren ab. SynthID Text kann beispielsweise auch nach kleineren Änderungen noch erkannt werden. Wird ein Text jedoch gründlich umgeschrieben oder übersetzt, kann die Erkennung deutlich schwieriger werden.
Wenn ein Prüfprogramm kein Wasserzeichen findet, beweist das daher nicht, dass ein Mensch den Text geschrieben hat.
Und selbst ein erkanntes Wasserzeichen beantwortet noch nicht automatisch, wie viel redaktionelle Arbeit anschließend in den Text geflossen ist.
Müssen wir KI-Texte überhaupt erkennen können?
Für mich ist das im Grunde die Kernfrage.
Wenn ich einen Fachartikel lese, möchte ich wissen, ob seine Aussagen stimmen, ob die Beispiele nachvollziehbar sind und ob der Autor tatsächlich etwas zum Thema beizutragen hat.
Ein vollständig selbst geschriebener Text kann oberflächlich, fehlerhaft oder langweilig sein.
Ein mit KI-Unterstützung entstandener Text kann dagegen konkrete Erfahrungen vermitteln, sauber recherchiert und sorgfältig überarbeitet sein.
Die Art seiner Entstehung sagt allein jedoch wenig über seine Qualität aus.
Natürlich gibt es Situationen, in denen die Herkunft wichtig ist. Etwa wenn eine eigenständige Prüfungsleistung verlangt wird, ein Text bewusst als persönliche Erfahrung ausgegeben wird oder eine Kennzeichnungspflicht besteht.
Bei einem gewöhnlichen Fachbeitrag interessiert mich zunächst, was darin steht und ob ich nach dem Lesen tatsächlich etwas verstanden habe, das ich vorher noch nicht wusste.
Was ich beim Schreiben mit KI anders mache
Ich werde KI weiterhin als Werkzeug einsetzen, denn sie spart mir viel Zeit.
Aber ich möchte mich in meinen Texten anschließend auch wiedererkennen.
Deshalb gehe ich beim Überarbeiten konsequent vor.
Ich streiche Formulierungen, die zwar gut klingen, aber keine zusätzliche Information enthalten.
Ich ersetze allgemeine Behauptungen durch konkrete Beispiele. Und ich prüfe, ob ein Satz tatsächlich meine Aussage trifft oder lediglich so klingt, als müsste an dieser Stelle etwas Wichtiges stehen.
Manchmal ist die beste Überarbeitung überraschend einfach: einen ganzen Absatz löschen.
Bei anderen Stellen muss ich selbst noch einmal nachdenken. Was will ich eigentlich sagen? Woher weiß ich das? Und welches Beispiel würde ich jemandem erzählen, der mir im Gespräch gegenübersitzt?
Die KI kann mir dabei helfen, meine Gedanken zu ordnen.
Den Gedanken selbst muss ich allerdings erst einmal haben.
Auch mit konkreten Vorgaben bekomme ich nicht immer den gewünschten Schreibstil. Bestimmte Formulierungen tauchen wieder auf, obwohl ich sie mehrmals ausdrücklich ausgeschlossen habe.
Deshalb verlasse ich mich nicht darauf, dass ein guter Prompt die redaktionelle Überarbeitung ersetzt.
Weichmacher pauschal zu verbieten, wäre allerdings genauso unsinnig. Entscheidend ist, ob eine Einschränkung inhaltlich notwendig ist oder eine Aussage nur unnötig verwässert.
Fazit: Einem guten Text geht mehr voraus als ein guter Prompt
Wir können bei KI-generierten Texten die Verwendung bestimmter Formulierungen erkennen. Aber nicht zuverlässig.
Und so, wie sich KI weiterentwickelt, stellt sich die Frage, wie lange das überhaupt noch erkennbar bleibt.
Sprachliche Muster können Hinweise liefern, technische Detektoren und Wasserzeichen können unter bestimmten Bedingungen zusätzliche Informationen bieten. Keines dieser Verfahren beantwortet allein jede Frage nach der Herkunft eines Textes.
Für meine eigene Arbeit ziehe ich daraus eine andere Konsequenz:
Ich schaue beim Schreiben genauer hin.
Wenn ein Absatz klingt, als könnte er unverändert unter hundert anderen LinkedIn-Beiträgen stehen, frage ich mich, ob er überhaupt in meinen Artikel gehört.
Und wenn ich nach dem Lesen meines eigenen Textes denke: „Das würde ich so niemals sagen“, dann fliegt der Satz raus.
Auch wenn ChatGPT ihn noch so überzeugend findet.